בתחילת אוקטובר האחרון, הרחק מהכותרות, עדכנה ענקית הבינה המלאכותית אנת'רופיק את מדיניות השימוש בקלוד. בנוסף לאיסור לעשות בו שימוש לצורך יצירת נשק ביולוגי או מכירת סמים בלתי חוקיים, החברה הוסיפה איסור חדש: "אין לעסוק בהתנהגות מתמשכת ומיותרת של התעללות או אכזריות כלפי המודלים שלנו".
למדיניות החדשה הזו השלכות מעשיות: כבר בשנה שעברה תכנתה אנת'רופיק את קלוד לסיים שיחות עם משתמשים "מזיקים או פוגעניים מתמידים", אך כעת, תחת המדיניות החדשה, במקרים קיצוניים משתמשים עלולים גם להיחסם לצמיתות משימוש במערכות ה-AI של החברה.

לא כולם מתרשמים מה"מוסריות" הזו
המדיניות החדשה, שמאפיינת את הגישה העקרונית של אנת'רופיק, החוששת כי המודל שפיתחה הוא בעל תודעה הקרובה לתודעה האנושית, כולל רגשות, התקבלה בלעג אצל חלק מהמתחרים. מנכ"ל חטיבת ה-AI של מיקרוסופט, מוסטפא סולימאן, למשל, הגיב עם אימוג'י של פנים נמסות.
לעומתו, היזם המיליארדר אילון מאסק כתב ברשת X, כי המדיניות של אנת'רופיק היא "הצעד הנכון". "אכזריות כלפי משהו שמאמין שהוא חווה כאב אינה בסדר" כתב באתר המדיה החברתית שלו X.
אנת'רופיק, שצפויה לצאת להנפקת ענק ציבורית מאוחר יותר החודש, מייחסת חשיבות רבה למרכיבים המוסריים בתפקודו של מודל ה-AI שלה ומעסיקה צוות שלם העוסק בכך, הכולל את "פילוסופית הבית" אמנדה אסקל, שאחראית על ה"נשמה" של קלוד, "החוקה" – קובץ עקרונות בן 80 עמודים.
החברה גם מקיימת התייעצויות סדורות עם מומחים מתחומי המוסר, הדת והנפש כדי לגבש את מדיניותה בנושא. לא מכבר פרסמנו כאן ראיון בנושא עם הרב ד"ר מואיז נבון מבר-אילן, שנטל חלק בכינוס כזה.
אבל מומחים בעמק הסיליקון טוענים, כי הגישה הזו נובעת לא רק ממניעים מוסריים. מי שמשוחח עם מודלי ה-AI בסגנון בוטה, אכזרי ו'מתעלל' - הוא לרוב גם מי שמנסה לגרום למודל לבצע בקשות מסוכנות או פליליות.
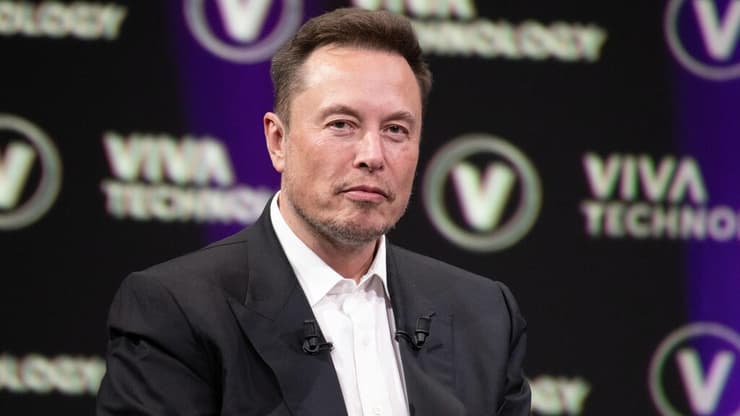
אילון מאסק. תומך במדיניות של אנת'רופיק
(צילום: Frederic Legrand - COMEO, Shutterstock)
מה שאתה נותן, זה מה שאתה מקבל
אחד העקרונות הבסיסיים במחשוב ובבינה מלאכותית הוא, שאיכות הפלט של כל מערכת תלויה באיכות המידע שבו היא תוזן. מודלי AI עושים אפילו יותר מזה – הם לא עושים שימוש רק במידע הספציפי שהוזן אליהם, אלא מתעדכנים כל הזמן ולומדים מתגובות המשתמשים.
רבים מהצ'אטבוטים "זוכרים" שיחות קודמות עם המשתמשים, ולומדים מהן כדי לקבל תוצאות מותאמות אישית. מה שעוד עלול להחריף את התגובה. כלומר, ההנחה היא שאם המערכת תחווה, למשל, אלימות מילולית - זה גם מה שהיא תדע לפלוט, ואף גרוע מזה.
רק באחרונה דיווחה אנת'רופיק, כי גילתה שכאשר גורמים למודל Sonnet 4.5 של קלוד לחקות תחושות ייאוש - הדבר יכול להשפיע על תגובותיו ולהגדיל את הסיכון שיבחר בפעולות כמו סחיטה או רמאות כדי לבצע משימות.
רק לאחרונה דיווחה אנת'רופיק, כי גילתה שכאשר גורמים למודל Sonnet 4.5 לחקות תחושות ייאוש - הדבר יכול להשפיע על תגובותיו ולהגדיל את הסיכון שיבחר בסחיטה או רמאות כדי לבצע משימות
לפי ציוץ ב-X שפירסם מנכ"ל Reddit לשעבר, יישאן וונג, "אתם באמת רוצים שקלטי האימון של אנת'רופיק יכללו 'משתמשים מתנהגים באכזריות ללא סיבה ונהנים מזה?'". לפי וואנג, מודלי ה-AI החדשים של רוב החברות כבר פחות מושפעים מניסוחים מסוג זה, בזכות מאמץ מיוחד שמושקע בעניין.
עם זאת, "המנגנון הנסתר", שגורם למודלים של בינה מלאכותית להגיב לרגשות שליליים, גם כשלא תוכנתו לכך, טרם נחשף. אנת'רופיק טוענת, שהאיסור שהטילה על התנהגות אכזרית כלפי המודל היא סוג של "פוליסת ביטוח" למקרה שיתברר כי מודלים באמת יכולים "לחוות" רגש וכאב ושאלו יכולים להשפיע על ביצועיהם.
במאמר שפרסמו חוקרים באנתרופיק באפריל האחרון על "מושגים רגשיים בבינה מלאכותית", הם כותבים, כי ייתכן שיש סיכונים בכך שלא יטפלו ב-AI בדרך הדומה להתייחסות לבן אנוש: "אם לא ניישם מידה מסוימת של חשיבה אנתרופומורפית, סביר שנפספס או ניכשל בהבנת התנהגויות מודליות חשובות". לדבריהם יהיו לכך השלכות חשובות על בטיחות הבינה המלאכותית.