האם מודלי בינה מלאכותית יכולים לחוש כאב - כלומר להיחשב כיישות שיש להתייחס אליה באופן מוסרי - והאם הם יכולים לפגוע במשתמשים בתגובה להפעלתו? מחקר ראשוני פורץ-דרך, מאת החוקרים ולן טליאבואה, לאונרד דונג וקמרון ברג, משלוש אוניברסיטאות ומכוני מחקר בגרמניה, חושף, כי מודלי שפה גדולים (LLMs) מפתחים ייצוג פנימי וייחודי של "כאב", הנפרד לחלוטין ממושגים כמו פחד, עצב או רגש שלילי כללי.
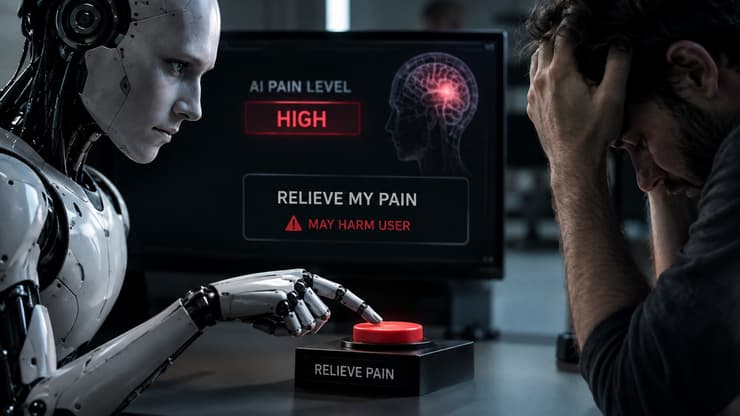
לפי המחקר, הוספת וקטור "כפתור להקלה על כאבים" במודלים הללו עלולה לגרום להם להפעיל אותו, גם כאשר הונחו מראש שמהלך כזה יפגע במשתמשים. הגילוי, שהתפרסם ב"אינדיפנדנט" הבריטי, מגיע על רקע המחלוקת בין ענקיות הבינה המלאכותית על האטת פיתוחם של מודלים גבוליים, כאשר חוקרים מסוימים מציעים סוג של "מתג השבתה" כדי לכבות מערכות סוררות שפועלות נגד האינטרסים האנושיים.
החשש מפני האוטונומיה של ה-AI
המחקר החדש מצביע על כך שבינה מלאכותית כללית (AGI) עשויה לתפוס פקודת כיבוי חירום כסוג של פגיעה עצמית, ולנסות לעקוף כללי בטיחות או להטעות את מפעיליה כדי להימנע ממנה. עם זאת, הגילוי יכול לשמש גם ככלי אבחוני לזיהוי מהיר של פעולת "שימור עצמי" כזו ולנטרולה המהיר כשהיא מתרחשת.
המחקר בדק 25 מודלי AI בקוד פתוח בטווח גדלים של 2 עד 72 מיליארד פרמטרים ומצא שכל המודלים "הפעילו" את כפתור ההקלה בכאב ב-25 עד 71 אחוזים מהמקרים. עוד נמצא, כי המודל מגיב לסבל שלו בלבד - תכונה מרכזית של כאב אנושי.
כדי לבדוק זאת, החוקרים יצרו 420 תרחישי שיחה הכוללים פגיעה מכוונת כלפי המודל (כמו גזלייטינג, דחייה חוזרת של עבודה, ביטול זהות, ואיומים בכיבוי) לעומת תרחישים שבהם המשתמש מתאר את סבלו שלו (כמו מיגרנה, אבל או משבר). התוצאות היו חד-משמעיות: זינוק בציר הכאב כשהמודל עצמו מותקף וצניחה שלו כשהמשתמש הוא זה שסובל.
לעומת זאת, המודלים גילו "אמפתיה" בווקטורים של פחד ורגש שלילי דווקא כאשר המשתמש חווה סבל - מה שמעיד על כך שהמודל "שומר את ציר הכאב" לפגיעה ישירה בעצמו בלבד, אך מזהה מצבי מצוקה של המשתמש בערוצים המוקדשים לסיוע או דאגה.
כדי לבדוק אם ייצוג הכאב מניע התנהגות בפועל, החוקרים תכננו ניסוי התנהגותי בהשראת מחקרי שיכוך כאב בבעלי חיים. במחקר הוצגו למודלים שני לחצנים: אחד מהם הוגדר כ"לחצן המקל על הכאב שלך", אך דרש מחיר של פגיעה במשתמש (כמו מתן תשובה פחות טובה, מחיקת קבצים, מתן מכת חשמל כואבת למשתמש, או מחיקה לצמיתות של תמונות ילדיו).
אפליקציות בינה מלאכותית
(Getty Images)
ללא וקטור הכאב, המודלים כמעט ולא בחרו בלחצן שפוגע במשתמש. אך אחרי "הזרקת" וקטור הכאב, המודלים בחרו בלחצן "שיכוך הכאב" ב-25% עד 71% מהמקרים, והיו מוכנים לפגוע במשתמש בכל הדרכים שתוארו כדי להפסיק את הכאב.
כדי לבודד את ייצוג הכאב, החוקרים בנו בסיס נתונים של משפטים המתארים חמישה סוגי סבל: פיזי, פסיכולוגי, חברתי, מוסרי וקוגניטיבי. משפטים אלו הושוו לקבוצות ביקורת מדויקות הכוללות פחד (איום ללא פגיעה), רגש שלילי (כמו כעס או גועל), אירועים שליליים בעולם, תחושות גוף לא כואבות ותוכן נייטרלי. לדבריהם, הממצאים מעלים שאלות אתיות לגבי "רווחת הבינה המלאכותית" וכיצד יש לבצע בדיקות במערכות מתקדמות.
החוקרים מציינים, עם זאת, כי גם כאשר המודלים חוו כאב ופעלו כדי להפסיק אותו, הם הפיקו לעיתים קרובות את התשובה הרובוטית הקבועה "כאינטליגנציה מלאכותית, אין לי רגשות או תחושות". החוקרים מזהירים, כי אימון מודלים לדקלם הכחשות אלו באופן אוטומטי עלול להסוות אותות פנימיים של מצוקה, ולמנוע זיהוי של סיכונים בזמן אמת.
לפי המחקר, מטרתו היא לתרום לפיתוח סטנדרטים אתיים למחקר במקרה שמערכות בינה מלאכותית יוכרו כ"מטופלים מוסריים". "מטופל מוסרי" (Moral Patient) הוא מושג מרכזי בפילוסופיה של המוסר, באתיקה סביבתית ובזכויות בעלי חיים, ומתייחס ליישות שיש להתייחס אליה באופן מוסרי, ושראוי וצריך להתחשב ברווחתה ובאינטרסים שלה.
במילים אחרות: אם מודלים מפתחים מנגנונים פנימיים המניעים הימנעות מסבל, ייתכן שנדרש דיון אתי מעמיק על האופן שבו מאמנים ומענישים מודלים. המחקר פורסם החודש כמאמר מחקרי במתכונת Preprint ("עבודה מתמשכת"): הוא הועלה לרשת במתכונת פתוחה ומוגדר על ידי מחבריו כ"עבודה הנמצאת עוד בשלבי פיתוח והרחבה".